Dos familias de algoritmos. Un producto que maneja su equipo.
Responden a las dos preguntas que todo equipo de producción se hace cada día: qué está saliendo mal y cómo trabajar mejor. Las dos son deliberadamente genéricas, de modo que valen tanto en fabricación de proceso como discreta; usted las entrena con sus propios datos.
«¿Qué está saliendo mal?»
Cada señal puntuada de forma continua, en tiempo real y con todas las variables en conjunto. Los umbrales, las derivas y las alarmas se generan automáticamente, y cada alerta se traza hasta las variables que la provocan, en lugar de hasta una puntuación compuesta sobre la que nadie puede actuar.
Como solo se utiliza el pasado para producir una puntuación, lo que valida offline es lo que se ejecuta en la línea.
«¿Cómo trabajar mejor?»
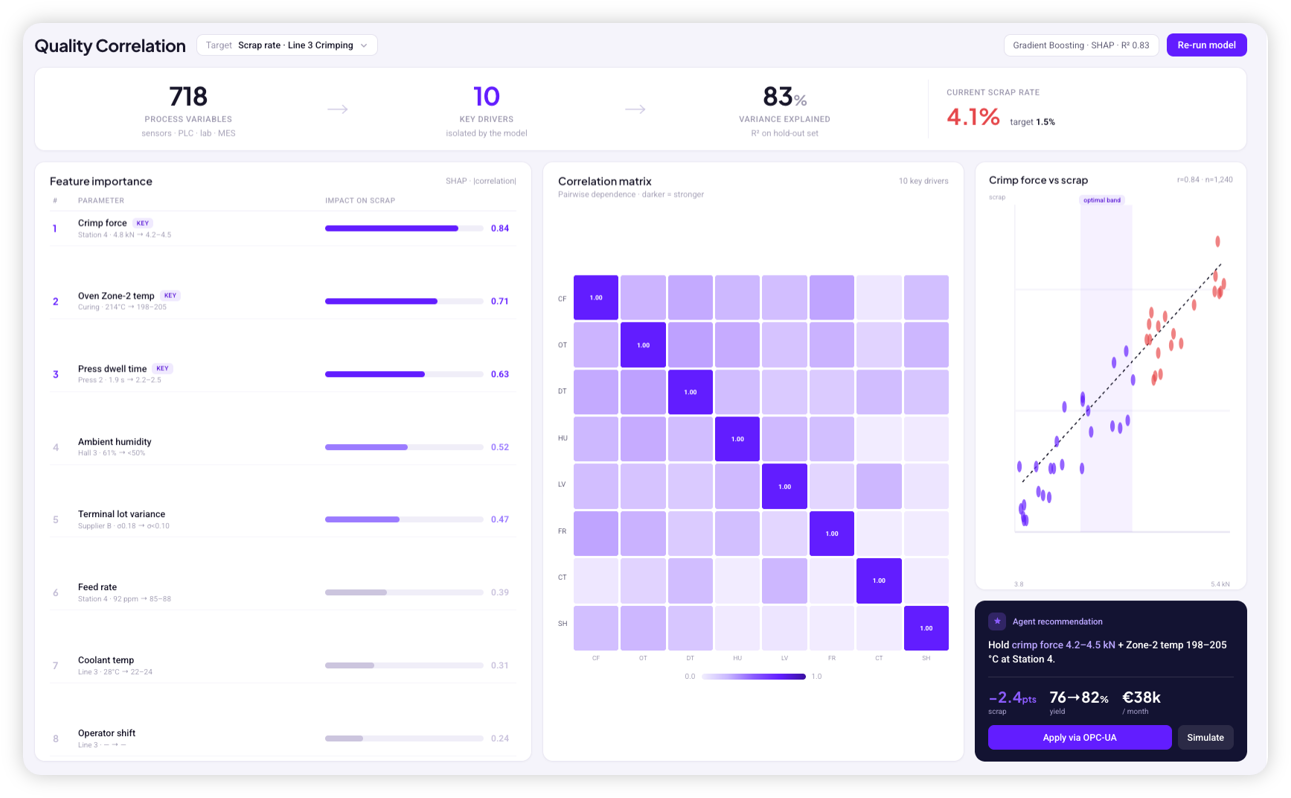
La influencia de cada variable cuantificada frente a su objetivo, y las regiones óptimas de operación identificadas. Lo que se devuelve es un rango de consigna por palanca retenida, no un modelo que alguien deba interpretar, más el resultado esperado dentro de cada zona.
También predice resultados a partir de parámetros que aún no ha producido, y todo lo que va más allá de su historial de producción se etiqueta como extrapolación.
No simplificamos el workflow de ciencia de datos. Lo integramos.
La selección de variables, el preprocesado, la selección de modelo, el ajuste, la calibración y las comprobaciones de fiabilidad se ejecutan dentro del producto. El usuario nunca los toca.
- Datos
- Cualquier fuente o formato: nosotros los ingerimos, los limpiamos y les damos forma. No se pide a su equipo ninguna fase de preparación de datos.
- Modelo
- Selección automática, entrenamiento en un clic y una comprobación de fiabilidad antes de mostrarle nada.
- Aplicación
- Conclusiones escritas para la planta, no para revisores. Un responsable de producción conecta los datos, ejecuta los modelos, lee el resultado y actúa.
- Tras un cambio
- Reentrenar un modelo tras un cambio de proceso cuesta un clic y unos treinta segundos, y lo hace su propio equipo.
Un modelo construido para un proceso no se amortiza entre plantas.
Los modelos de primeros principios y los gemelos digitales son excelentes donde encajan, y hay que reconstruirlos para cada proceso al que se aplican. Por eso empiezan en seis cifras y se quedan en la parte alta del mercado.
Entrenados por usted, con lo suyo
Las dos familias son deliberadamente genéricas para ser robustas ante cualquier caso de uso, y específicas de su planta porque se entrenan con los datos de su planta.
Se extiende dentro de la planta
Construido para el responsable de planta y no para el analista, que es lo que le permite pasar de una línea a la siguiente sin un proyecto nuevo cada vez.
Y entre plantas
El mismo producto cubre la detección de defectos, los parámetros de proceso, la energía, el OEE (eficiencia general de los equipos) y el mantenimiento predictivo, tanto en fabricación de proceso como discreta.
Indique una línea y una variable objetivo.
Leemos la exportación que ya genera y le decimos en una semana si contiene las palancas.


