Zwei Algorithmenfamilien. Ein Produkt, das Ihr Team betreibt.
Sie beantworten die zwei Fragen, die jedes Produktionsteam jeden Tag stellt: was läuft schief, und wie fahren wir besser. Beide sind absichtlich generisch, damit sie in der Prozess- wie in der Stückfertigung tragen — Sie trainieren sie auf Ihren eigenen Daten.
„Was läuft schief?“
Jedes Signal wird laufend gescort, in Echtzeit und über die Variablen hinweg gemeinsam. Schwellen, Driften und Alarme entstehen automatisch, und jede Meldung wird auf die Variablen dahinter zurückgeführt und nicht auf einen Sammelscore, mit dem niemand etwas anfangen kann.
Weil zur Erzeugung eines Scores immer nur die Vergangenheit genutzt wird, ist das, was Sie offline validieren, dasselbe, was auf der Linie läuft.
„Wie fahren wir besser?“
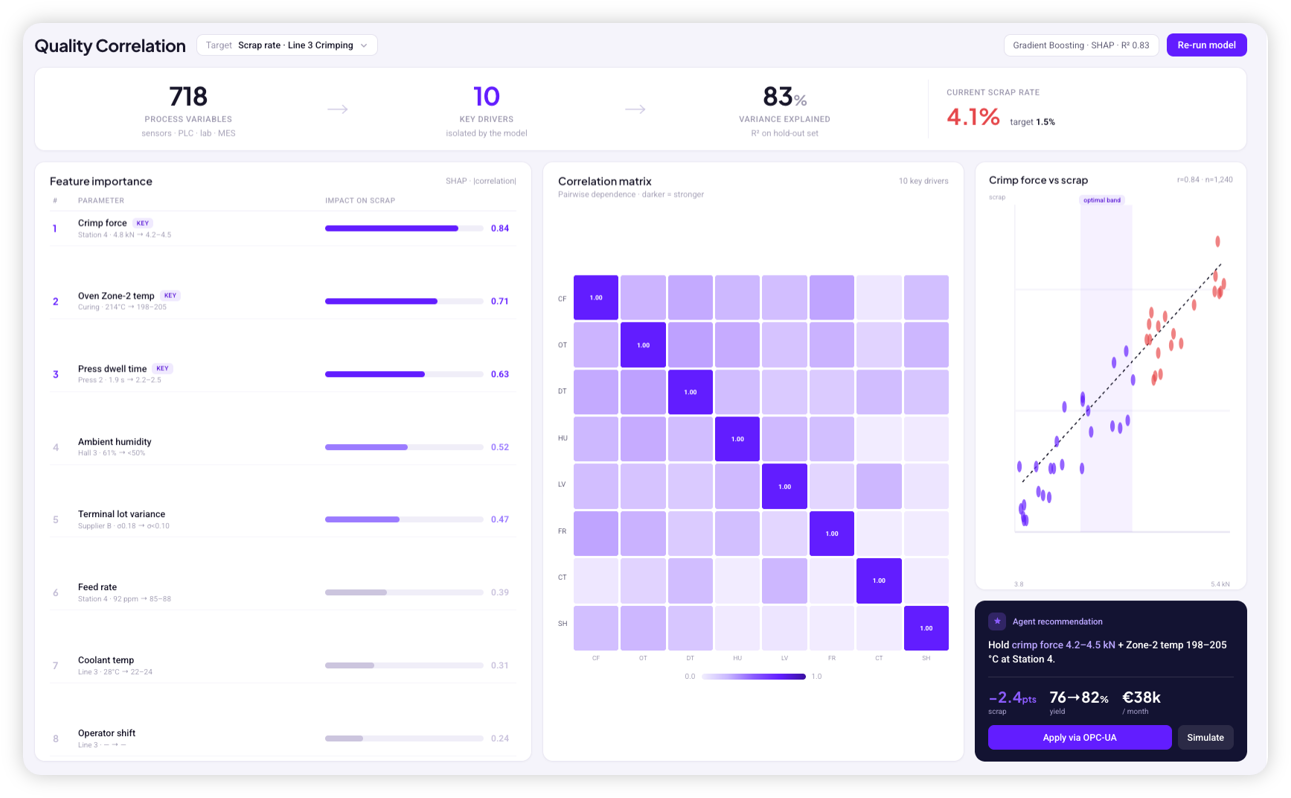
Der Einfluss jeder Variablen wird gegen Ihre Zielgröße quantifiziert und die optimalen Betriebsbereiche werden bestimmt. Zurück kommt ein Sollwertbereich pro beibehaltenem Hebel — kein Modell, das jemand interpretieren muss — plus das Ergebnis, das in jedem Sollbereich zu erwarten ist.
Es sagt auch Ergebnisse für Parameter voraus, die Sie noch nicht gefahren haben, wobei alles jenseits Ihrer Produktionshistorie als Extrapolation gekennzeichnet wird.
Wir haben den Data-Science-Workflow nicht vereinfacht. Wir haben ihn eingebaut.
Variablenauswahl, Vorverarbeitung, Modellauswahl, Tuning, Kalibrierung und Vertrauensprüfungen laufen alle im Produkt. Der Nutzer berührt sie nie.
- Daten
- Jede Quelle, jedes Format — von uns eingelesen, bereinigt und in Form gebracht. Von Ihrem Team wird keine Phase der Datenvorbereitung verlangt.
- Modell
- Automatische Auswahl, Training per Klick und eine Vertrauensprüfung, bevor Ihnen etwas gezeigt wird.
- Anwendung
- Schlussfolgerungen, geschrieben für die Werkshalle, nicht für Gutachter. Ein Produktionsleiter verbindet die Daten, lässt die Modelle laufen, liest das Ergebnis und handelt.
- Nach einer Änderung
- Ein Modell nach einer Prozessänderung neu zu trainieren dauert einen Klick und etwa dreißig Sekunden, durchgeführt von Ihrem eigenen Team.
Ein Modell für einen Prozess amortisiert sich nicht über Werke hinweg.
Physikalische Modelle und digitale Zwillinge sind exzellent, wo sie passen, und sie müssen für jeden Prozess neu gebaut werden, den sie berühren. Deshalb beginnen sie im sechsstelligen Bereich und bleiben am oberen Ende des Markts.
Von Ihnen trainiert, auf Ihren Daten
Die zwei Familien sind absichtlich generisch, damit sie gegen jeden Anwendungsfall robust sind, und spezifisch für Ihr Werk, weil sie auf den Daten Ihres Werks trainiert werden.
Breitet sich im Werk aus
Für den Werksleiter gebaut und nicht für den Analysten — das ist es, was die Ausbreitung von einer Linie zur nächsten erlaubt, ohne jedes Mal ein neues Projekt.
Und über Werke hinweg
Dasselbe Produkt deckt Fehlererkennung, Prozessparameter, Energie, OEE (Gesamtanlageneffektivität) und vorausschauende Instandhaltung ab — in der Prozess- wie in der Stückfertigung.
Nennen Sie eine Linie und eine Zielgröße.
Wir lesen den Export, den Sie bereits erzeugen, und sagen Ihnen innerhalb einer Woche, ob er die Hebel trägt.


